Nell’ottobre 2023, durante il processo antitrust intentato dal Dipartimento di Giustizia americano, Pandu Nayak ha testimoniato sotto giuramento speigando per sommi capi come funziona la ricerca Google. Ti ricordo che Nayak è vicepresidente della ricerca e lavora sulla qualità dei risultati dal 2004. La sua testimonianza occupa centinaia di pagine. Tra le altre cose, ha confermato che Google usa i clic degli utenti per ordinare i risultati, attraverso un sistema chiamato Navboost. Per anni, a domande simili, Google aveva risposto con la vaghezza propria di un oroscopo!
A maggio 2024 è finita online la documentazione interna di una delle API di ricerca di Google. Dentro c’erano nomi di sistemi, attributi e metriche che nessuno aveva mai visto confermati ufficialmente.
Sai come funziona Google? Nel dettaglio nemmeno io. Credo che nessuno lo sappia per intero, nemmeno dentro l’azienda: i sistemi sono tanti e cambiano di continuo. Se vuoi puoi partire dai brevetti, che Google raccoglie su Google Patents. Auguri 😃
Per farti un’idea precisa ci sono tre fonti affidabili. La prima è la guida ufficiale di Google sul funzionamento della ricerca. La seconda è la documentazione sui sistemi di ranking. La terza è quello che è uscito dal processo e dal leak, che spesso raccoglie dettagli che si discostano dalle dichiarazioni ufficiali.
A tutte queste info aggiungo quello che osservo nelle SERP da quando faccio SEO, cioè dal 2012. Se sei curioso sul mio approccio in generale all’ottimizzazione sui motori di ricerca, lo nell’articolo su cos’è la SEO.
Le 5 fasi della ricerca Google
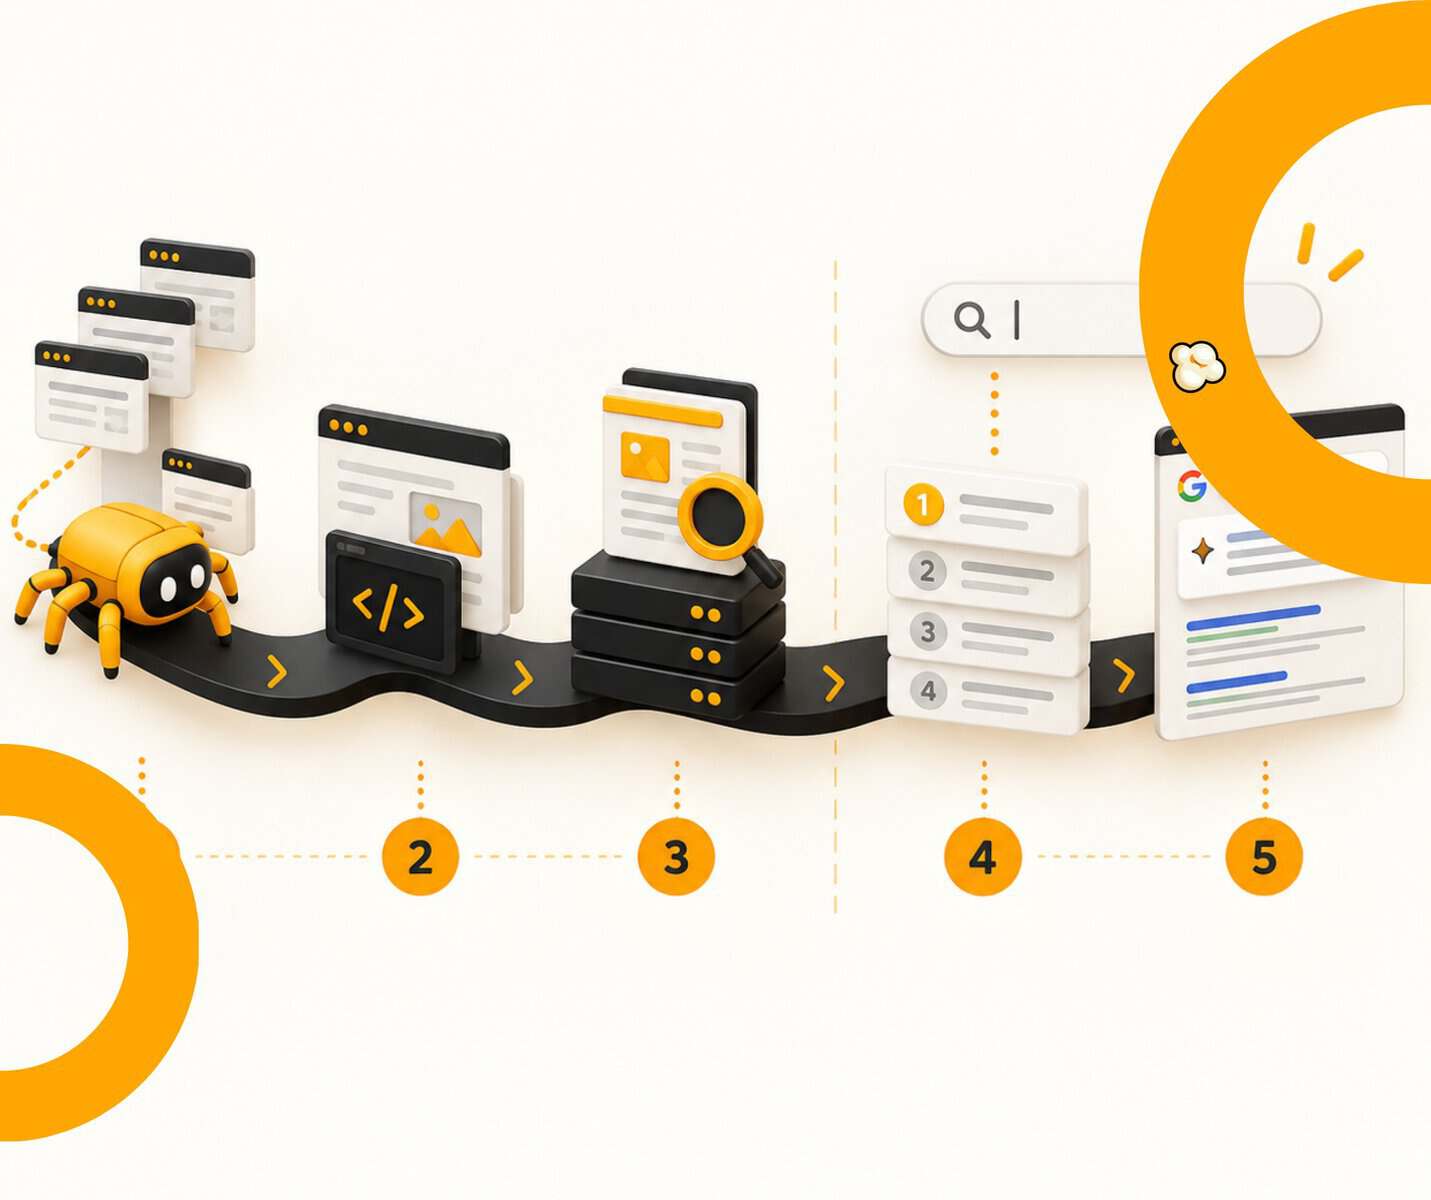
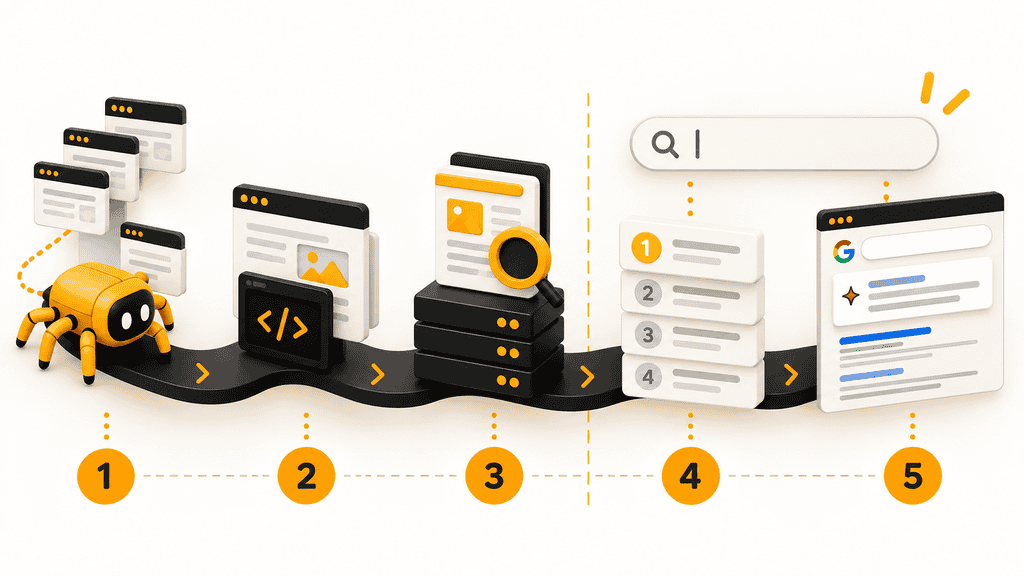
Nella sua guida, Google descrive la ricerca in tre fasi: scansione, indicizzazione e pubblicazione dei risultati. Io preferisco dividerle in cinque, perché dentro quelle tre ci sono passaggi che funzionano in modo molto diverso. Su ognuno di questi passaggi puoi intervenire in un modo diverso.
- Scansione (crawling): i crawler di Google scoprono le pagine seguendo i link e le scaricano;
- Rendering: Google esegue il codice della pagina, JavaScript compreso, per vederla come la vedresti tu nel browser;
- Indicizzazione (indexing): Google analizza il contenuto, sceglie quale versione tenere tra pagine molto simili e la archivia nel suo indice.
- Ranking: quando fai una ricerca, i sistemi di ranking ordinano le pagine dell’indice in base alla tua query;
- Pubblicazione: Google compone la pagina dei risultati che vedi. Oggi ci aggiunge spesso anche una risposta generata dall’AI.
Le prime tre fasi si completano prima della ricerca dell’utente e vanno avanti di continuo. Le ultime due succedono dopo la ricerca, ogni volta che un utente digita una query.
So che sembra una distinzione ovvia, ma spesso si fa confusione utilizzando indicizzazione e posizionamento come sinonimi. Dimmi che non ti è mai capitato di sentire “abbiamo indicizzato la pagina in prima posizione!”.
Al netto del brivido che mi dà anche solo scriverlo, sono due cose diverse. Una pagina indicizzata è una pagina che Google conosce e che può mostrarti. Se te la mostra, e dove, lo decide il ranking.
Scansione
Google non ha un registro centrale di tutte le pagine del web. Le deve scoprire e lo fa con dei software chiamati crawler, il più noto dei quali è Googlebot. Il crawler visita le pagine accessibili pubblicamente, segue i link che trova e le scarica. Le pagine nuove arrivano soprattutto da due strade: i link da pagine che Google conosce già e le sitemap che gli segnali tu.
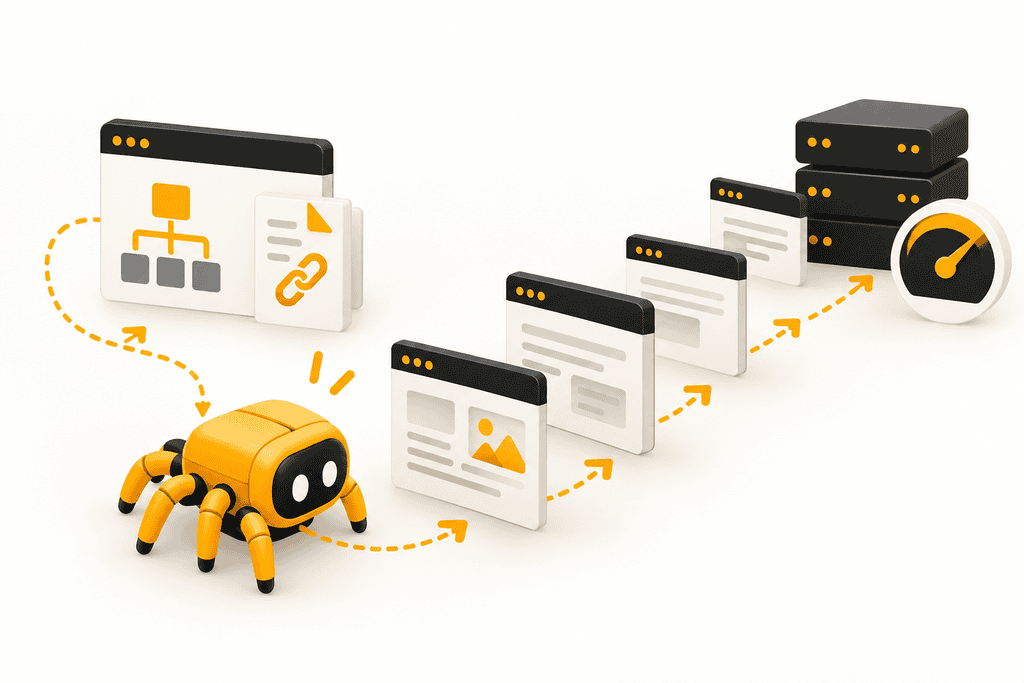
Prima ancora della scansione c’è una fase di programmazione, detta scheduling. Google decide quali URL visitare, quanto spesso e con che velocità. Tiene conto anche del tuo server: se risponde lento o restituisce errori, Googlebot rallenta per non sovraccaricarlo.
C’è un limite tecnico che vale la pena conoscere: Googlebot legge solo i primi 2 MB dell’HTML di una pagina, non compresso. Tutto quello che viene dopo, per Google, non esiste. Per darti una misura, l’HTML di una pagina tipica pesa intorno ai 30 KB, quindi quasi nessuno ci arriva vicino. I casi a rischio sono le categorie ecommerce con centinaia di prodotti e dati strutturati per ognuno, oppure i siti costruiti con framework JavaScript che infilano nell’HTML enormi blocchi di dati.
Se vuoi decidere cosa Google può scansionare, lo strumento è il robots.txt. Da qualche anno esiste anche Google-Extended, un’istruzione del robots.txt che ti permette di escludere i tuoi contenuti dall’addestramento dei modelli Gemini, senza ovviamente toglierti dalla Ricerca, né dalle AI Overviews.
Tutto questo succede automaticamente. A meno che tu non abbia bloccato la scansione o segnalato le pagine come “da non indicizzare”, nella maggior parte dei casi Google trova il tuo sito senza bisogno che un SEO faccia niente di speciale. Se qualcuno ti propone di “indicizzarti il sito”, o sta confondendo indicizzazione e posizionamento o ti sta vendendo qualcosa di cui non hai bisogno (salvo casi limite!).
Un SEO può invece facilitare il lavoro del crawler: una sitemap pulita, link interni che raggiungono ogni pagina importante, niente pagine orfane, un server veloce. Se vuoi approfondire, trovi tutto nel mio articolo su scansione e indicizzazione di un sito su Google.
Rendering
Una volta scaricata la pagina, Google la deve leggere come farebbe un browser. L’HTML che arriva dal server spesso è solo una parte del contenuto: il resto lo costruisce il JavaScript quando la pagina viene aperta. Per vederlo, Google usa il Web Rendering Service, un sistema basato su una versione di Chrome sempre aggiornata, che esegue il codice e ricostruisce la pagina completa.
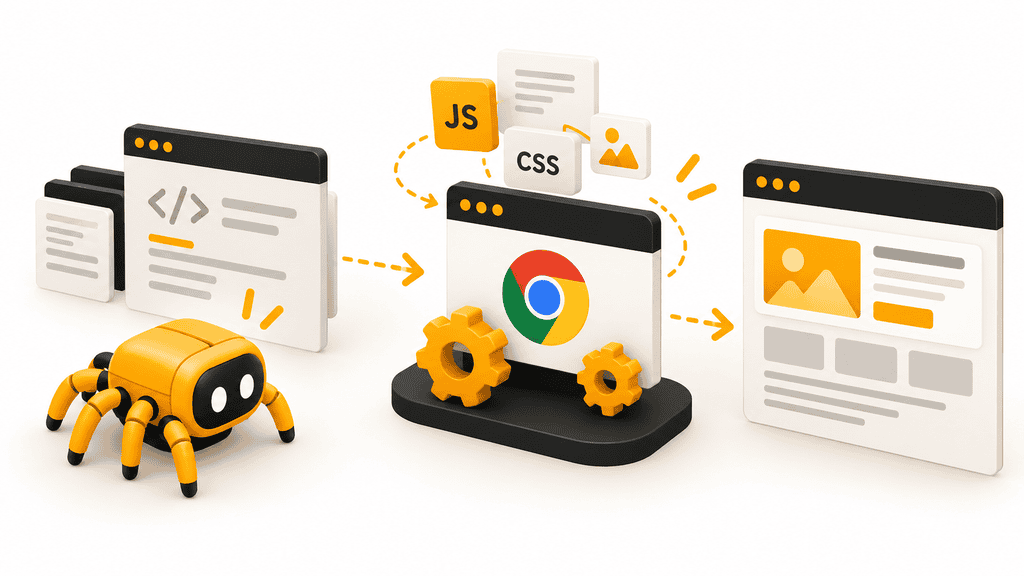
Il rendering non avviene nello stesso momento della scansione. Le pagine finiscono in una coda e vengono elaborate quando ci sono risorse disponibili. Di solito il ritardo è breve, ma intanto Google lavora sulla versione che ha, cioè sull’HTML iniziale.
Da qui nascono i problemi più comuni. Se il contenuto principale compare solo dopo un clic, uno scroll o un’interazione, Google può non vederlo. Se i link sono gestiti da JavaScript senza un normale tag <a href>, Google non li segue. Se blocchi file CSS o JavaScript nel robots.txt, Google ricostruisce una pagina diversa da quella che vede il tuo utente. E se nell’HTML iniziale c’è un noindex, Google può fermarsi lì senza nemmeno arrivare al rendering, anche se poi il JavaScript lo toglie.
La soluzione più sicura è far arrivare dal server tutto il contenuto che conta, con il rendering lato server o con pagine pre-generate. Per verificare cosa vede Google, usa lo strumento Controllo URL di Search Console: ti mostra l’HTML dopo il rendering e ti dice se qualche risorsa non è stata caricata.
Indicizzazione
Quando la pagina è stata scansionata e ricostruita, Google ne analizza il contenuto: testi, titoli, immagini, video, dati strutturati, link. Da qui ricava i segnali che userà più avanti per il ranking e decide se la pagina merita di entrare nel suo indice, un archivio che secondo Google contiene centinaia di miliardi di pagine.
Non tutte le pagine scansionate vengono indicizzate. Se Google la considera poco utile, troppo simile ad altre o di bassa qualità, può lasciarla fuori. In Search Console lo vedi con lo stato “Scansionata, ma attualmente non indicizzata”, che è uno dei più frustranti da ricevere.
Un passaggio importante di questa fase è la canonicalizzazione. Quando Google trova più pagine con contenuti uguali o molto simili, le raggruppa e ne sceglie una sola da mostrare nei risultati: la pagina canonica. Il tag canonical per Google è un suggerimento forte. Di solito lo rispetta, ma se altri segnali dicono il contrario può scegliere un’altra pagina. Un canonical che punta a un URL in redirect, per esempio, manda messaggi contraddittori. Ne parlo nel dettaglio nell’articolo sulla canonicalizzazione degli URL.
L’indice di Google è formato da più indici diversi. Ci sono indici verticali per pagine web, immagini, video, notizie e altro, che confluiscono nella Universal Search, cioè la pagina dei risultati che mescola tutti questi formati.
Oltre alla scansione del web, Google alimenta i suoi indici con altre fonti: i feed di dati che ricevi o invii tu, come quelli di Merchant Center, le collaborazioni con enti terzi e il Knowledge Graph, il database di fatti ed entità che usa per i pannelli informativi.
In questa fase un SEO può fare molto. Il compito è far capire a Google quale pagina risponde a quale argomento, e distinguerla dalle altre pagine simili del tuo sito. Se due pagine si contendono la stessa ricerca, Google deve sceglierne una, e non è detto che scelga quella giusta. È il problema della cannibalizzazione.
Ranking
Quando fai una ricerca, i sistemi di ranking di Google pescano dall’indice le pagine pertinenti e le mettono in ordine, in una frazione di secondo. Per farlo usano due tipi di segnali. Alcuni sono stati raccolti prima, durante l’indicizzazione, da tutto quello che Google ha archiviato: le pagine scansionate, i feed di dati, le collaborazioni con enti terzi e il Knowledge Graph. Altri dipendono dal momento: dove ti trovi, che lingua usi, se l’argomento che cerchi è legato a qualcosa appena successo.
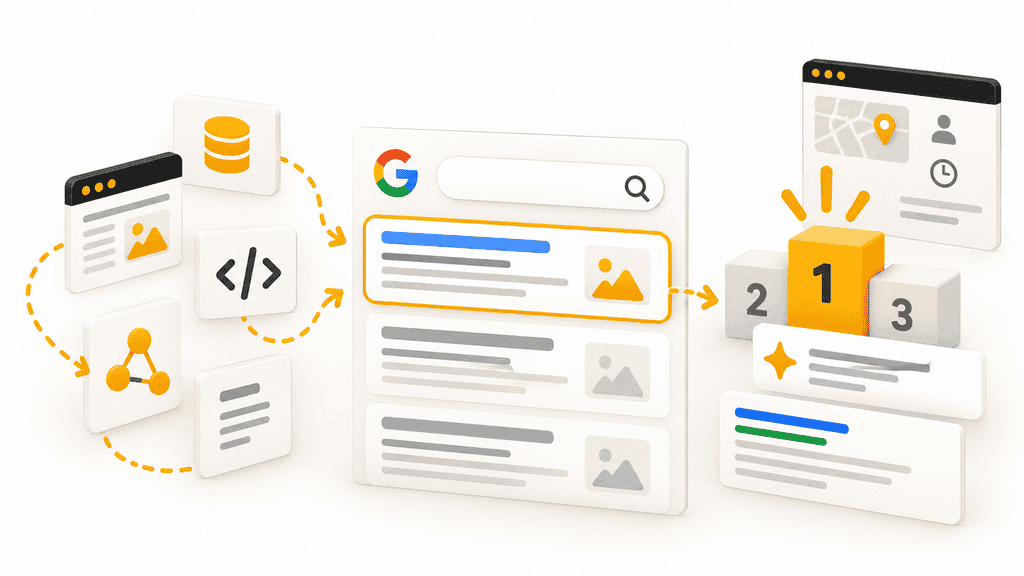
Questa è la fase che tutti inseguono, quella delle famose prime posizioni. Io sono un po’ allergico alla parola posizionamento, perché la vedo usata spesso nel modo sbagliato. Molti SEO si vantano di essere “primi” per una parola chiave, e si dimenticano che:
- la SERP che vedi tu può essere diversa da quella di un utente a 500 chilometri, con un altro dispositivo e un’altra lingua. E sopra i risultati, sempre più spesso, c’è una risposta generata dall’AI che spinge tutto il resto più in basso. Essere primi oggi vale meno di qualche anno fa;
- l’epoca del “una parola chiave per pagina” è finita da un pezzo. Google capisce l’obiettivo di chi cerca e lo stesso obiettivo si esprime con decine di query diverse. Se hai posizionato una query e ne hai perse dieci, perché non le avevi considerate o perché qualcosa è andato storto, non è un gran risultato;
- come fai a sapere che la query su cui sei primo è quella che conta davvero per i tuoi utenti? Quella più vicina alla conversione? Quella che resterà uguale nel tempo?
Parlare di “posizionare parole chiave” riduce quello che la SEO può fare oggi. È uno spreco, e andrebbe smesso di venderlo.
Google raggruppa i fattori principali del ranking in cinque famiglie: il significato della query, la pertinenza, la qualità, l’usabilità e il contesto.
Significato della query
Prima di cercare una risposta, Google deve capire cosa stai cercando. Per farlo usa modelli linguistici che correggono gli errori di battitura e riconoscono i sinonimi. Per Google, “cambiare luminosità del display” e “regolare luminosità del display” sono la stessa richiesta.
Capire la query serve anche a decidere che tipo di risultato mostrarti. Se cerchi qualcosa con “ricetta”, Google ti propone ricette. Se scrivi in francese, ti mostra soprattutto risultati in francese. Se cerchi una notizia, preferisce contenuti freschi a quelli online da anni e mai aggiornati. È quello che nella comunità SEO chiamiamo search intent.
Pertinenza
La base della pertinenza è ancora la corrispondenza tra le parole della tua query e quelle della pagina, soprattutto nei punti che contano: titolo, intestazioni, testo principale. Da sola, però, non basta più da tempo.
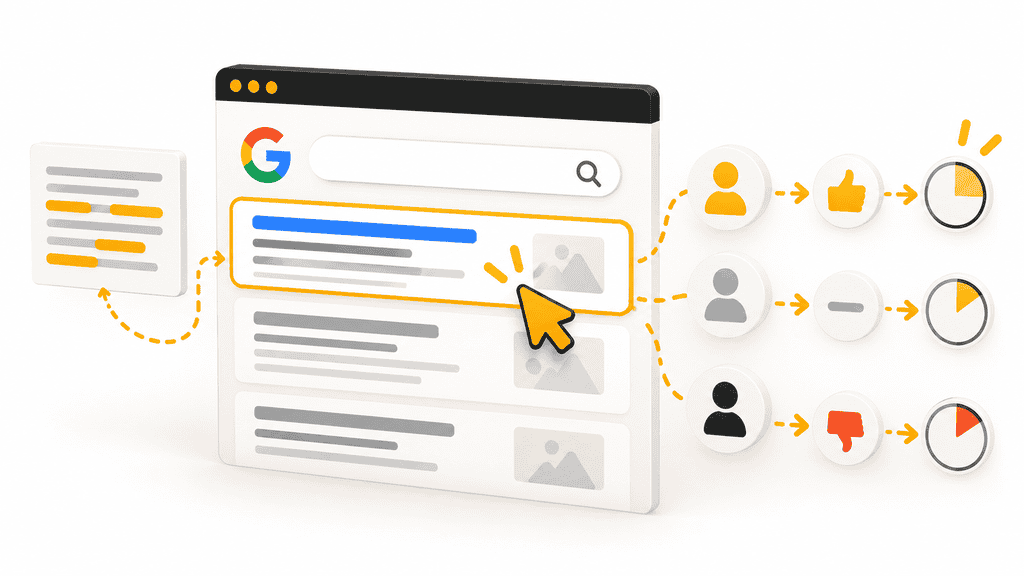
Google ha sempre ammesso di usare dati aggregati e anonimi sulle interazioni degli utenti con i risultati. Quanto contassero davvero lo abbiamo scoperto solo con il processo antitrust. Lì è emerso Navboost, un sistema che raccoglie la storia dei clic sui risultati e la usa per spostarli in su o in giù. Secondo la testimonianza, lavora su circa tredici mesi di dati. Il leak del 2024 ha mostrato che distingue diversi tipi di clic, tra cui i clic buoni, i clic cattivi e l’ultimo clic più lungo, cioè il risultato su cui l’utente si ferma alla fine della ricerca.
Quindi un risultato che le persone scelgono e su cui restano viene premiato. Un titolo acchiappaclic che delude chi entra, alla lunga, potrebbe costarti posizioni, traffico e conversioni.
Qualità
Qui entriamo in un vero ginepraio. Da una parte c’è quello che Google dichiara su come valuta la qualità. Dall’altra ci sono le SERP, dove capita spesso di trovare in alto risultati che violano in parte o del tutto le sue linee guida.
Restando all’ottica di Google, valutare la qualità significa capire se un contenuto è davvero utile per chi cerca. Il riferimento è l’EEAT, i quattro criteri con cui Google descrive un contenuto affidabile:
- Esperienza (Experience)
- Competenza (Expertise)
- Autorevolezza (Authoritativeness)
- Affidabilità (Trustworthiness)
L’EEAT viene dalle linee guida dei quality rater, persone che Google paga per valutare la qualità dei risultati. Il loro giudizio serve a testare le modifiche agli algoritmi e non sposta direttamente il posizionamento del tuo sito. Dal marzo 2024 anche l’Helpful Content System, nato proprio per premiare i contenuti utili, è stato assorbito nei sistemi di ranking principali.
Usabilità
A parità di pertinenza e qualità, l’esperienza sulla pagina può fare la differenza. I fattori principali li puoi immaginare da solo:
- una pagina che funziona bene su qualsiasi dispositivo, a partire da quello mobile;
- la velocità e la stabilità del caricamento, misurate dai Core Web Vitals. Da marzo 2024 la metrica di reattività è l’INP, che ha preso il posto del vecchio FID;
- l’accessibilità, intesa come pagina utilizzabile anche da chi ha una disabilità;
- l’assenza di popup e banner invadenti che coprono il contenuto.
Google ha una guida per valutare la page experience delle tue pagine. Se lavori nel web non ti cambierà la vita, ma qualche spunto utile lo trovi.
Contesto
L’ultimo fattore sei tu. Il segnale più forte è la posizione: se cerchi “ristorante”, Google ti mostra quelli vicino a dove ti trovi, rilevati dal GPS dello smartphone o dalla connessione che usi. È la base della local SEO. Contano anche la lingua e il dispositivo.
La cronologia di ricerca e i dati del tuo account Google possono influire sui risultati, ma pesano meno di quanto si pensi. Il caso tipico è una pagina che hai visitato più volte e che Google ti riporta più in alto.
I sistemi di ranking
Dietro queste cinque famiglie lavorano decine di sistemi automatici, ognuno specializzato in un aspetto. RankBrain collega le parole ai concetti. BERT capisce come la combinazione delle parole cambia il significato di una frase. Il neural matching abbina i concetti della query a quelli delle pagine. Il passage ranking valuta i singoli passaggi di un testo, oltre alla pagina intera.
Pubblicazione e risposte AI
L’ultima fase è quella che vedi: Google compone la pagina dei risultati. Accanto ai risultati organici può inserire featured snippet, immagini, video, mappe con le attività locali, schede prodotto. Anche qui lavorano dei sistemi dedicati. Se una pagina compare come featured snippet, Google non la ripete più sotto nella prima pagina. E di solito non ti mostra più di due risultati dallo stesso sito tra i primi, per evitare che un solo dominio occupi tutta la SERP.
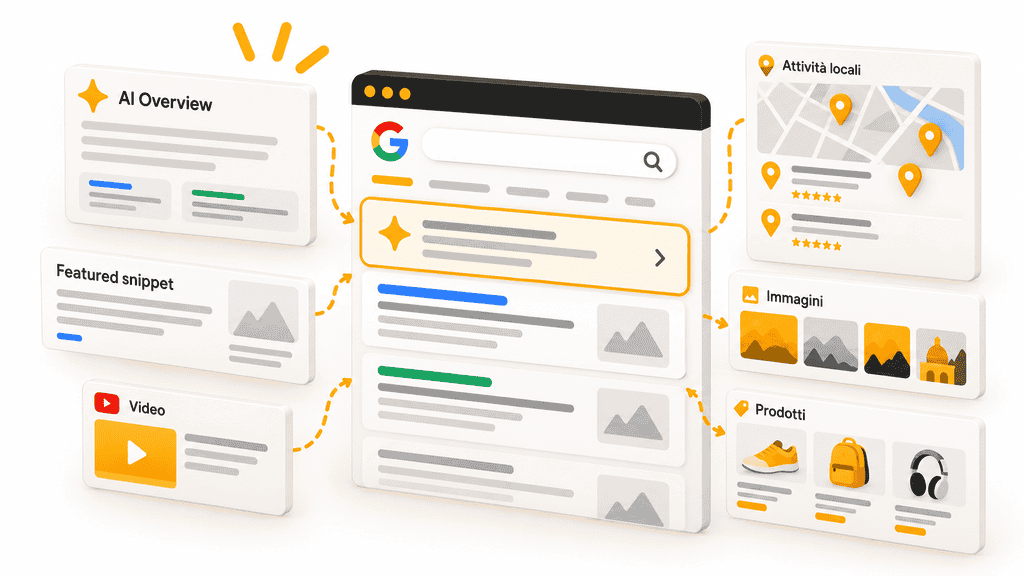
Da qualche anno, in cima a molte ricerche trovi anche una AI Overview: un riassunto generato dall’intelligenza artificiale, con i link alle fonti da cui è costruito. Dall’8 ottobre 2025 in Italia e in italiano c’è anche AI Mode, una scheda dei risultati e dell’app Google dove fai domande lunghe e articolate e ricevi una risposta conversazionale. Google racconta che chi la usa scrive domande due o tre volte più lunghe di una ricerca normale.
Query fan-out
Il meccanismo più interessante di AI Mode si chiama query fan-out. Quando fai una domanda complessa, Google la scompone in tante sotto-domande correlate, le cerca tutte in parallelo e mette insieme le risposte. Secondo Google, AI Mode si appoggia agli stessi sistemi di qualità e di ranking della ricerca classica. Quando non ha abbastanza fiducia in una risposta generata, ti mostra i normali risultati web.
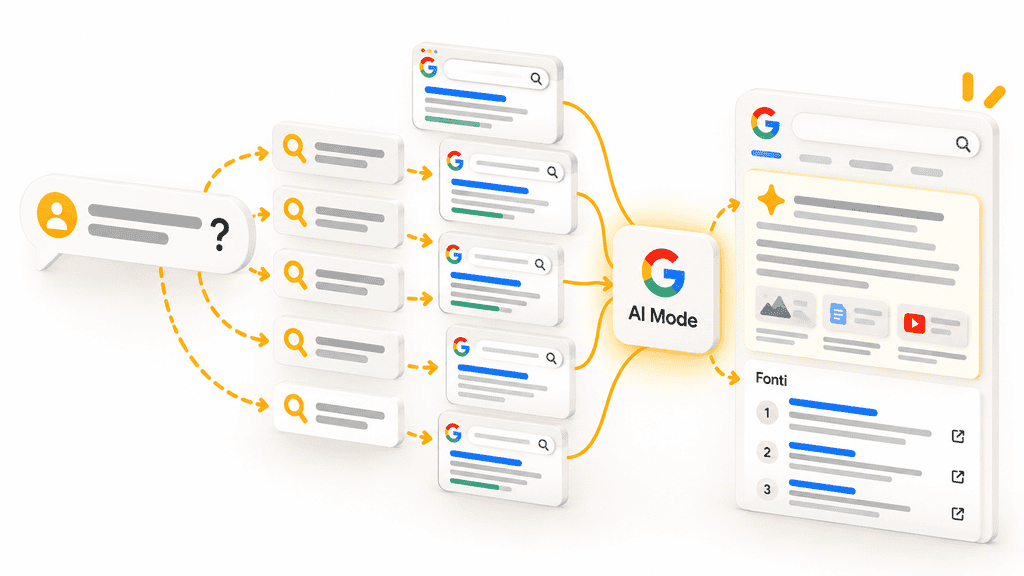
Per te questo ha due conseguenze. La prima: per essere citato in una risposta AI devi comunque essere scansionato, indicizzato e ben posizionato, almeno su qualcuna delle sotto-domande. La seconda: il fan-out porta all’estremo quello che dicevo sul “una parola chiave per pagina”. Un obiettivo di ricerca diventa decine di query, e vince chi le copre bene. Ne parlo nell’articolo sulla GEO e in quello su ruoli e architettura nella SERP.
C’è anche un rovescio della medaglia. Se la risposta arriva direttamente in SERP, molte persone non cliccano più. Editori e siti di contenuti denunciano cali di traffico dall’arrivo delle AI Overviews, e con AI Mode il rischio cresce.
Conclusioni
Come immaginavi, il funzionamento di Google è tutt’altro che semplice. E l’azienda è restia a raccontarlo nel dettaglio, per un motivo comprensibile: più informazioni rilascia, più è facile manipolare i risultati. Google stessa racconta che, dopo la pubblicazione dell’articolo originale sul PageRank nel 1998, molti spammer iniziarono a pagarsi i link a vicenda per scalare le classifiche. La sua versione della storia la trovi nella pagina su come combatte lo spam, di cui ti riporto sotto alcune righe.
Combattere lo spam per mantenere i risultati utili e sicuri costituisce una sfida quotidiana. Vogliamo essere trasparenti sul funzionamento della Ricerca, ma dobbiamo fare anche attenzione a non rivelare troppi dettagli che permetterebbero di manipolarne i risultati e di peggiorare l’esperienza per tutti.
È una lezione che abbiamo imparato a nostre spese: nel 1999 i fondatori di Google pubblicarono un articolo su PageRank, un’importante innovazione dell’algoritmo di Google. Dopo che l’articolo venne pubblicato, molti spammer cercarono di manipolare Google pagandosi tra loro per i link.
Il processo antitrust e il leak hanno però mostrato una certa distanza tra quello che Google dichiarava e quello che succedeva davvero. Per anni il peso dei clic è stato minimizzato, poi è finito in una testimonianza sotto giuramento. Quando ho scritto la prima versione di questo articolo avevo espresso dubbi sull’efficacia dell’Helpful Content System, guardando chi occupava le prime posizioni. Con quello che sappiamo oggi, quella diffidenza aveva qualche base.
Prova però a immaginare un mondo in cui la più grande banca dati di informazioni sia facile da manipolare. Cercare informazioni su Google diventerebbe inutile, e in certi casi pericoloso.
È anche una questione economica. Se Google perdesse la fiducia di chi lo usa, perderebbe il suo prodotto principale, come è successo a tanti motori di ricerca prima di lui. Mi piace comunque pensare che dentro l’azienda ci siano ancora persone consapevoli di quanto quel prodotto possa aiutare il mondo, o danneggiarlo.